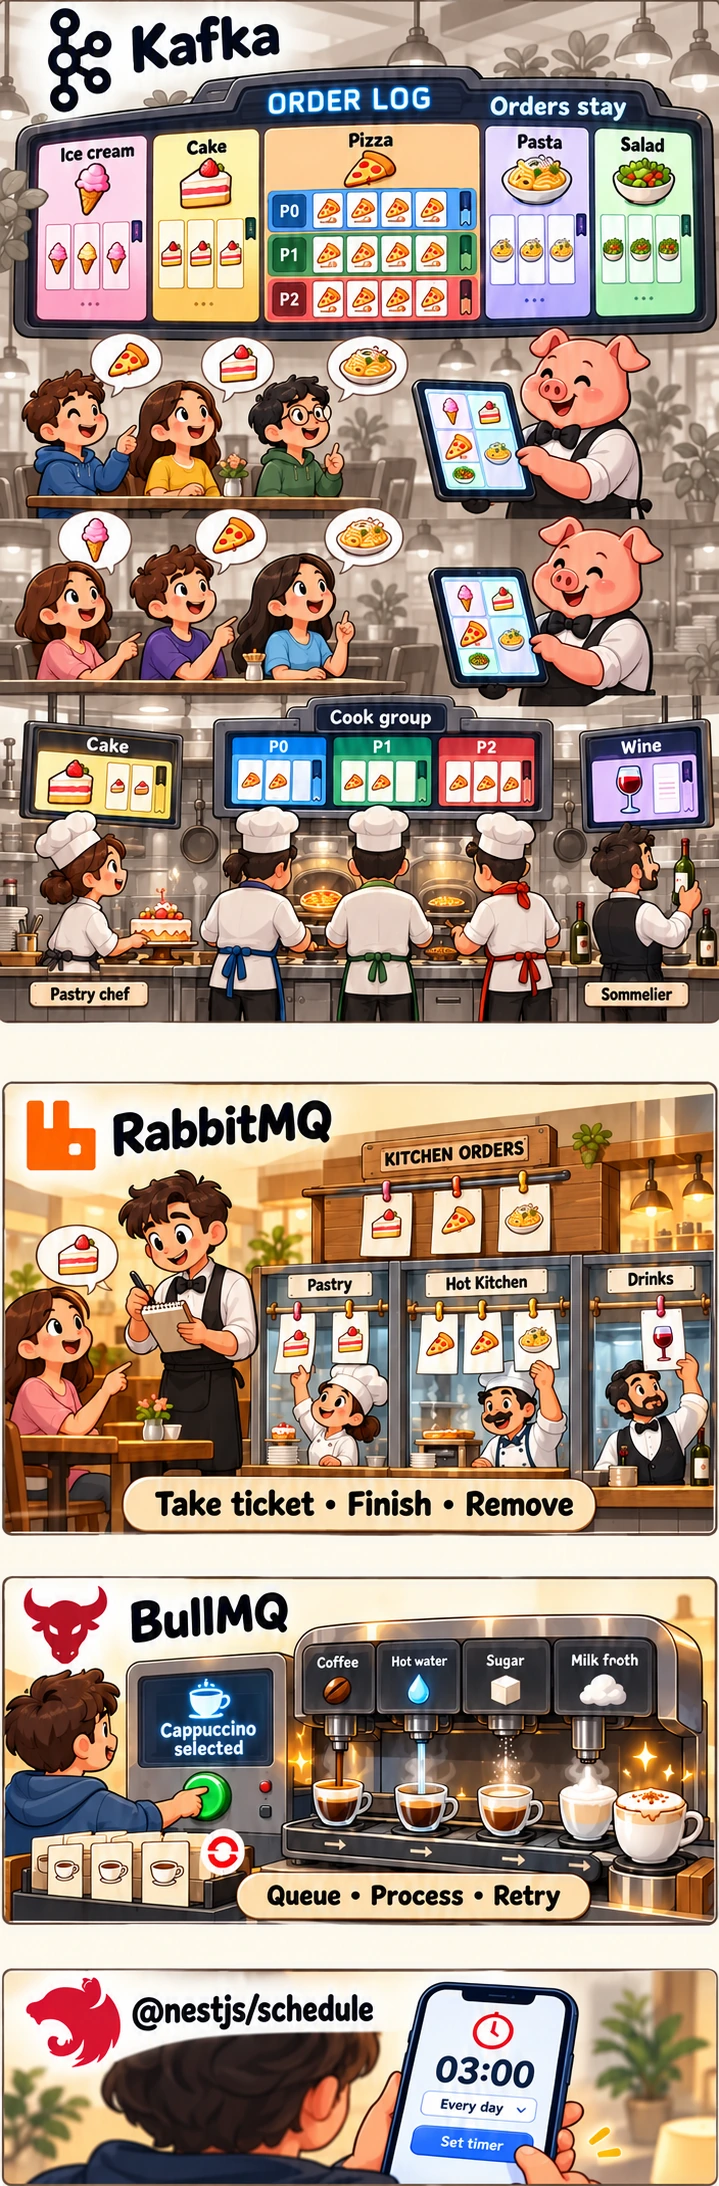
Időzített feladatok
Szinte bármilyen, a nagyközönség számára készített projekt eljut arra a pontra, hogy szüksége lesz időzített feladatokra.
- Ha biztosítani akarjuk az adatok megőrzését, valószínűleg nem magunknak állítunk időzítőt, hogy minden este másoljuk át az adatbázist egy független szerverre.
- Ha nem akarunk minden adatot a végtelenségig tárolni, fölöslegesen növelve az infrastruktúránk költségeit, akkor időzített takarításokat végzünk.
- Ha külső forrásból is szükségünk van adatokra, akkor időközönként frissítenünk kell azokat.
- Ha időhöz kötötten szeretnénk értesítést küldeni, akkor időzítenünk kell az üzeneteket.
Tovább is sorolhatnám, a lényeg, hogy az időzített feladatok egy hasznos és szinte megkerülhetetlen csoport. Általában a keretrendszer, amiben dolgozunk, rendelkezik olyan csomaggal, ami ilyen feladatok létrehozását lehetővé teszi. NestJS (szokásos példám) esetében ez a @nestjs/schedule.
Használata egyszerű. Behívjuk a ScheduleModule.forRoot()-t vagy az AppModule-ba vagy egy dedikált Scheduler modulba, amit később az AppModule használhat. Ez után a service-ekben olyan végrehajtó függvényeket definiálunk, amelyek a cron kifejezésben megadott időben végrehajtanak egy feladatot. Például:
  @Cron(CronExpression.EVERY_DAY_AT_1AM)
  async handle(): Promise<void> {
    const deleted = await this.metrics.instrumentJob(
      'in-app-notification-cleanup',
      () => this.inAppNotificationService.sweepExpired(),
      { items: (n) => n },
    );

    if (deleted > 0) {
      this.logger.log(`Purged ${deleted} expired notification(s).`);
    }
  }
Az időzítő logikája egyszerű. Amikor felépül a NestJS program, időzített intervallumokat határoz meg. Amikor eltelik az adott intervallum és épp nincs más az eseményhurokban (event loop), akkor végrehajtódik a feladat. Ez utóbbiból következik, hogy az időzítés nem tökéletesen pontos, ha a node process leterhelt. Az időmérésért az operációs rendszer felel, a node program pihen, ha nincs végrehajtandó munka.
A példában látható, hogy adatokat gyűjtünk a feladatról, így monitorozni lehet, hogy mikor válik problémássá, mikor válik annyira erőforrás-igényessé, hogy már ne engedhessük meg magunknak, hogy ugyanazon process futtassa, mint ami a bejövő kérésekre válaszol.
Egy helyen vagy egymástól függetlenül?
Ezzel el is jutottunk a következő szereplőnkhöz, a BullMQ-hoz. Ez még mindig egy node könyvtár, amit behívhatunk a projektbe, és még mindig futtathatjuk ugyanazon folyamatban, mint minden mást. Ez utóbbi megoldás egyszerűbb projekteknél teljesen rendben is van. Ha egy időben eltolt feladat 10-20 ms-ot igényel éjszakánként, amikor nincs érdemi aktivitás, nem érdemes miatta növelni a komplexitást.
A BullMQ viszont lehetőséget ad arra is, hogy egy külön worker.js-t futtassunk, így egy a fő eseményhuroktól eltérő folyamat felel majd olyan aszinkron feladatokért, amelyekkel nem szeretnénk a fő szálat terhelni. Persze külön folyamatot BullMQ nélkül is indíthatunk; a BullMQ a sorban álló feladatok tárolását, kiosztását és követését oldja meg.
A BullMQ alapműködése, hogy sorokat (queue-kat) tart számon vagy egy Redis vagy egy PostgreSQL adatbázisban (ami akkor is igaz, ha a worker az API-val közös folyamatban fut). A kliensek a különböző sorokba eseményeket küldenek.
// producer.ts

import { Queue } from 'bullmq';

const coffeeQueue = new Queue('coffee-orders', {
  connection: {
    host: '127.0.0.1',
    port: 6379,
  },
});

async function main() {
  try {
    const job = await coffeeQueue.add(
      'prepare-coffee',                  // Job name
      { drink: 'cappuccino', sugar: 2 },   // Job data
      {
        attempts: 3,
        backoff: {
            type: 'fixed',
            delay: 2000
        }
      }
    );

    console.log(`Order ${job.id} added to the queue.`);
  } finally {
    await coffeeQueue.close();
  }
}

main().catch(console.error);
Opcionálisan megadható, hogy hányszor próbálkozunk a feladat végrehajtásával, milyen időközönként.
Azután ezeket a feladatokat a végrehajtók ki tudják olvasni a sorból.
// worker.ts

import { Worker } from 'bullmq';
import { setTimeout as wait } from 'node:timers/promises';

type CoffeeOrder = {
  drink: string;
  sugar: number;
};

const worker = new Worker<CoffeeOrder>(
  'coffee-orders', // Must match the producer's queue name

  async (job) => {
    const { drink, sugar } = job.data;

    console.log(`Starting order ${job.id}: ${drink}`);

    // Simulate asynchronous machine operations.
    console.log('Adding coffee...');
    await wait(1000);

    console.log('Adding water...');
    await wait(1000);

    console.log(`Adding ${sugar} teaspoons of sugar...`);
    await wait(500);

    return { drink, ready: true };
  },

  {
    connection: {
      host: '127.0.0.1',
      port: 6379,
    },
    concurrency: 1,
  },
);

worker.on('completed', (job, result) => {
  console.log(`Order ${job.id} completed:`, result);
});

worker.on('failed', (job, error) => {
  console.error(`Order ${job?.id} failed:`, error.message);
});

worker.on('error', (error) => {
  console.error('Worker error:', error);
});

// Finish active work before closing when you press Ctrl+C.
process.on('SIGINT', async () => {
  await worker.close();
});
A concurrency: 1 azt jelenti, hogy egyszerre egy feladatot futtat a worker.
Értesítések kiküldésére például tökéletesen elegendő BullMQ-t használni. Egy felhasználói tevékenységre egyből vissza tudunk jelezni, az email tényleges kiküldését nem várjuk meg, hanem csak elindítjuk. Az megtörténik, amikor sorra kerül.
Ha már akkora a projekt, hogy microservice-ekre van szükség
Eljuthatunk arra a pontra, amikor már jelentős a forgalom és egy-egy funkciócsoport aránytalanul nagy terhelést jelent a meglévő infrastruktúrára. Ilyenkor érdemes ezeket kiszervezni külön szolgáltatásokba, külön konténerekbe, külön szerverekre. Ilyenkor azonban megjelenik az elosztott rendszerek fő kérdése, hogy hogyan oldjuk meg az aszinkron kommunikációt a microservice-ek között.
Erre lehet megoldás a RabbitMQ, ami egy önálló üzenetközvetítő (message broker). Saját környezetben fut, saját megoldása van az események tárolására és elosztására.
A producerek a RabbitMQ brókeren belüli exchange-nek publikálnak üzeneteket. Az exchange a beállított szabályok alapján egy vagy több sorba irányítja őket, ahonnan a fogyasztók megkapják az üzeneteket. Egy fogyasztó, ha végrehajtotta a feladatot, visszajelez a brókernek, és az esemény törlődik az adott sorból.
Ha megtörténik a feldolgozás, de a visszajelzés nem, akkor ugyanaz a feladat újra végrehajtásra kerülhet. Ezért fontos az idempotencia, vagyis hogy a függvény többszöri futtatása mindig ugyanazt a hatást eredményezi, mintha egyszer futtatták volna.
Az üzenetek ilyen módon való kezelésével megoldható az, hogy egyetlen elem átmeneti kiesése ne akadályozza más szolgáltatások működését, mert a kérés nem számít szinkron válaszra egyik résztvevőtől sem.
Amikor az eseményeket később is fel akarjuk dolgozni
Lehetséges, hogy eljutunk arra a pontra, amikor már milliós a felhasználóbázis és lehetségesek olyan események, amikor több millió kérés is beérkezhet egy másodperc alatt. Például egy Black Friday-akció indulása egy nagy online piactéren. Ha a rendszerünk nincs felkészítve az ilyen jellegű csúcsokra, akkor pont a legrosszabb pillanatban képes feladni, nem kevés csalódottságot okozva.
Ilyen eseteknél már fordulhatunk a nehézsúlyú szereplőnkhöz, a Kafkához. Elosztott architektúrájának köszönhetően hatalmas átmenő forgalmat képes kezelni. Több csomópont viselkedhet üzenetbrókerként és több csomópont lehet felelős a metaadatok tárolásáért. (A KRaft bevezetése óta egy csomópont mindkét szereppel rendelkezhet.)
A Kafka esetében topic-okat határozhatunk meg, amelyekre fogyasztók vagy fogyasztói csoportok iratkozhatnak fel. A topic-ok egy vagy több partícióból állnak. A partíciók lehetővé teszik, hogy egy fogyasztói csoport tagjai párhuzamosan dolgozzanak: egy partíciót a csoporton belül egyszerre egy fogyasztó olvas, de egy fogyasztóhoz több partíció is tartozhat.
Másik nagy különbség a RabbitMQ hagyományos üzenetsoraihoz képest, hogy a feldolgozott események nem tűnnek el automatikusan a logból. Megőrzésüket a beállított tárolási és takarítási szabályok határozzák meg. Így sokáig visszakereshetőek. Az egyik blogger arról is beszámolt, hogy sérült adatbázist is állítottak már vissza Kafka logokból.
Természetesen ez nem jelenti azt, hogy helyettesíti az adatbázisokat!
A service-ek közti kommunikáción kívül használható még valós idejű streamek kezelésére, mint amilyen például a valós idejű lokációkövetés.
Persze attól, hogy lelki szemeink előtt már ott lebeg a milliós felhasználóbázis, még nyugodtan igyuk meg a kávénkat. Nem kell nekiugrani a Kafka-implementációnak, ha most még rajtunk kívül csak anyukánk használja az appunkat, nem foglalkozunk valós idejű adatfolyamokkal és a kérés/másodperc még legtöbbször egy alatt van, vagy 200 alatt…
A Kafka használata jelentősen növelheti a komplexitást, nem beszélve a plusz infrastrukturális költségekről. Általában akkor kerül szóba, ha nagyobb termékről van szó, amelyen egy egész csapat dolgozik, lehetőleg dedikált DevOps-ossal. Kisebb rendszereknél is szóba jöhet, ha az események megőrzése és későbbi újrafeldolgozása fontos.
Zárszó
Sokat gondolkodtam, hogy merjek-e írni a témáról, hiszen nem mondható, hogy több évtizedes tapasztalatom lenne hatalmas rendszerek karbantartásában. A legtöbb szenior backendesnek valószínűleg nem tudok újat mondani (meg a legtöbb botnak, legyünk reálisak az “olvasóközönségemet” illetően 😁).
Végül mégis rászántam magam, mert hasznosnak éreztem áttekinteni, hogy milyen feladatokra milyen eszközök jöhetnek szóba. Legközelebb pedig, ha lesz egy időzített feladat, fel tudom tenni a kérdést, hogy mekkora a kapacitásigénye, mikor lesz érdemes kiszervezni.