Mi az SQL?
Az SQL (Structured Query Language) nyelv teszi lehetővé, hogy az emberi fogalmakhoz közel álló deklaratív utasításokat adjunk egy kiválasztott adatbázisnak, hogy milyen adatokra van szükségünk. Mivel különböző adatbázis-rendszerek eltérő módon implementálják és bővítik az SQL szabványt, az SQL-nek több dialektusa is létezik. Ezek eltérnek egymástól abban, hogy milyen kulcsszavakat használnak, bár az alapvető parancsokban nagy az átfedés. A későbbiekben elsősorban a PostgreSQL-lel fogok példálózni.
Van értelme foglalkozni SQL tanulással az AI korában?
Jó kérdés. Hacsak nem drágul az AI használat a sokszorosára, talán már soha nem lesz hatékony kézzel írni a lekérdezéseket. Ha nem vagy Yoda szintű backend fejlesztő, valószínűleg az AI több kulcsszavat és megoldást ismer, illetve gyorsabban is gépel, mint te.
Ami engem illet, hosszú évekig elsősorban frontenddel foglalkoztam és az utóbbi években is ORM-ek segítségével, úgymond “light mode”-ban írtam a lekérdezéseket. Így amikor áttértem intenzív AI használatra magas szintű AI ügynökökkel, akkor kódellenőrzés során olyan nyers SQL megoldásokba futottam, amelyek elegánsnak tűntek, képesek voltak egy lépésben több feladatot megoldani, de úgy éreztem, hogy nincs meg a tudásom ahhoz, hogy kiszúrjam, ha éppen kicsit nem jók. Ilyenkor általában futtattam rá még néhány code-review-t, de azért ott maradt a kellemetlen érzés a gyomromban.
Minden téren az AI-al összemérhető tudást valószínűleg nem tudunk építeni, de azért még él bennem a törekvés, hogy minél többet tanuljak, minél több kontroll maradjon a kezemben.
Természetesen a legjobb módja a tanulásnak, ha belefektetjük az időt és erőfeszítéseket teszünk, hogy magunk oldjunk meg problémákat. Kérdés, hogy van-e erre idő. A szoftver iparágban a gyors prototípusnak komoly előnye van, mert hiába a tied a legelegánsabb lekérdezés, ha a konkurencia az alatt az idő alatt három körben tesztelte már a felhasználóit.
Szóval nem, nem írom kézzel a lekérdezéseket. Viszont irattam egy kis PostgreSQL kvízt, ami feleletválasztós, így doomscrolling helyett egy-egy “flibberigibbetting”-re való várakozás alatt futok vele egy-egy kört. Itt érhető el, ha téged is érdekel:
Abban reménykedem, hogy segít csökkenteni a gyomorgörcsöt. Majd kiderül. Első körben lehet, hogy növelte. 😀
Alapfogalmak
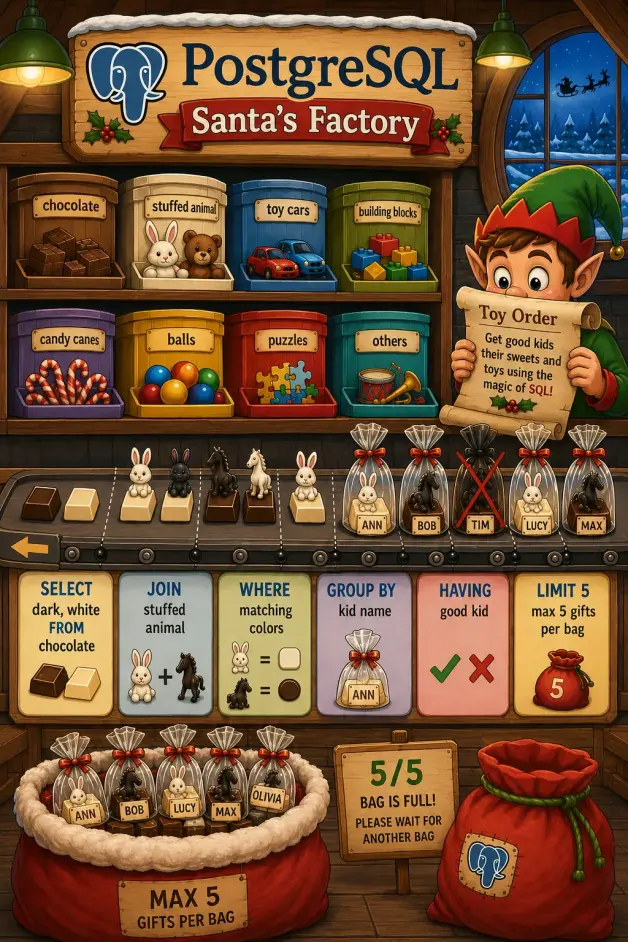
Az SQL jobb ismeretével a célunk az, hogy olyan lekérdezéseket tervezzünk, amelyek nem túl erőforrásigényesek. Ehhez mindenképp jó tisztában lenni az alap parancsok természetével. Melyek növelik a visszaadandó sorok számát és melyek csökkentik azt.
SELECT column1, column2
Kerüljük a csillagot. Lehetőleg mindig adjuk meg, hogy mely oszlopok adataira van szükségünk, különben például egy későbbi tábla bővítés (text, JSONB, blob hozzáadás) meglepően lassúvá tud tenni egy olyan lekérdezést, ami nagyon sokáig kifejezetten gyors volt. Amúgy is jó stratégia, ha csak azt küldjük el, amire szükség van, kontrollálva a forgalmat és az érzékeny adatok kezelését.
FROM table1, table2
Több tábla esetén ma általában az explicit JOIN szintaxist használjuk, mert olvashatóbbá teszi a lekérdezésben szereplő kapcsolatok feltételeit.
INNER JOIN, LEFT JOIN, RIGHT JOIN
Ezek nagyon gyakran sokszorozó műveletek. Két táblának a sorait kombináljuk új sorokká. Például a felhasználók tábláját kombinálva a rendelések táblával egy one-to-many kapcsolat miatt egy felhasználó több sorban is megjelenhet: egyszer minden hozzá tartozó rendeléshez. Az ON feltételben határozzuk meg, hogy két tábla sorai milyen feltétel alapján számítanak egymáshoz tartozónak, például user.id = order.user_id. Szűrésre a WHERE is használható, de outer joinok esetén fontos különbség van a kettő között: az ON a JOIN során határozza meg a találatokat, míg a WHERE már a JOIN eredményét szűri. A JOIN típusok megkülönböztetéséről később még lesz szó.
WHERE
Szűkíti vagy változatlanul hagyja a találatokat, egyfajta szűrőként működik.
GROUP BY
Szűkítheti és transzformálhatja az eredményeket. Például nem azt kérjük, hogy adjon vissza minden rendelést adott időszakból, hanem adjon vissza személyenként csoportosítva minden rendelést adott időszakból. Így ha Anna három rendelést adott le, nem három, hanem csak egy sort fog elfoglalni a válaszban.
HAVING
A GROUP BY által létrehozott csoportokat szűri.
LIMIT
Tovább szűkíti az eredményeket. Megadja, hogy maximum hány adatot kérünk. Lapszámozás esetén gyakran előfordul. Lapszámozáskor általában ORDER BY-jal együtt használjuk, különben nem garantált, hogy az egyes oldalak stabilan ugyanazokat a sorokat tartalmazzák. Nagy táblák esetén, különösen egymást követő oldalak betöltésénél, a cursor- vagy keyset-alapú lapozás gyakran hatékonyabb, mint a nagy OFFSET értékek használata.
INNER JOIN vs LEFT JOIN
Kezdőknek hasznos információ lehet, hogy mi a különbség az INNER JOIN és a LEFT JOIN között. Előbbi esetében én mindig két kört képzelek el, amelyek metszete be van színezve, bár fontos, hogy valójában nem azonos elemeket keresünk, hanem a két tábla sorai közötti kapcsolatot. Az INNER JOIN csak azokat a sorpárokat adja vissza, amelyek megfelelnek a JOIN feltételének. Például:
Felhasználók:
1 Anna
2 Péter
3 Mária
Rendelések
1 10 db kalap Annától (user_id = 1)
2 5 db cipő Annától (user_id = 1)
3 2 db kabát Pétertől (user_id = 2)
Ebben az esetben, amit visszaad az INNER JOIN:
10 kalap Annától
5 cipő Annától
2 kabát Pétertől
Mária létezése nem derül ki az eredményekből.
Ezzel szemben LEFT JOIN esetében a bal oldali, vagyis a kérésben előbb szereplő táblázat minden eleméről szeretnénk információt kapni. Így néz ki a kérés:
    SELECT u.name, o.item
    FROM users u
    LEFT JOIN orders o
        ON u.id = o.user_id
A felhasználók vannak először megemlítve, tehát ők a bal oldal, így amit visszakapunk így néz ki:
Anna 10 kalap
Anna 5 cipő
Péter 2 kabát
Mária NULL
A RIGHT JOIN logikusan ennek a fordítottja. Sok csapatban ritkábban használják, mert ugyanaz a lekérdezés általában LEFT JOIN-nal is leírható a táblák sorrendjének felcserélésével, ami egységesebb olvasási irányt ad a kódnak.
EXPLAIN ANALYZE
Még több szintaxis helyett egy gyakorlati eszközre szeretnék még kitérni. Egy lekérdezést többféle végrehajtási stratégiával is meg lehet oldani. A PostgreSQL lekérdezéstervezője (query planner) statisztikák és költségbecslések alapján választ ezek közül.
Ha belépünk az adatbázisunk konténerébe, akkor adott kérést futtathatunk az EXPLAIN segítségével. Megmutatja, hogy a PostgreSQL query plannere milyen végrehajtási tervet választana a lekérdezéshez, valamint a tervhez tartozó költség- és sorszámbecsléseket. Ha az ANALYZE opciót is használjuk, a lekérdezés ténylegesen le is fut, így a becsült sorok és költségek összevethetők a valós végrehajtás során mért értékekkel.
Ezzel a módszerrel tudjuk tesztelni, hogy a gyorsítás kedvéért létrehozott indexeink felhasználásra kerülnek-e (ha nem ismerős az index fogalma, lásd Adatbázis alapok).
Azonban tartsuk szem előtt, hogy lokális környezetben sokszor töredék adatunk van egy éles környezethez képest. Ha itt futtatjuk a tesztet, akkor simán kaphatjuk azt a választ, hogy a terv szekvenciális lekérdezés (a teljes táblázat beolvasása), hiszen a 10 sornyi adatunknál ez egy hatékony stratégia.
Így ha ténylegesen tesztelni akarjuk az indexeinket, akkor érdemes olyan mennyiségű és eloszlású tesztadattal dolgozni, amely legalább nagyságrendileg közelít a várható éles használathoz.
Konklúzió
Egyre inkább hajlamosak vagyunk az AI-ra támaszkodni, ami által kevesebb a lehetőség a mélyebb tanulásra. Átfogó tudás nélkül azonban hol lesz a határ a stratégia és a reménykedés között? Nap mint nap keresem az egyensúlyt. Az biztos, hogy nem érzem azt, hogy hátradőlhetnék. 😅